Ce que Google lit dans une image, puis ce qu’il en fait : index, filtres, classement, IA
Google vend aux développeurs une partie de son analyse d’images : l’API Cloud Vision renvoie, pour une photo, les labels dont le score dépasse 0,5, chacun avec son MID. Les images générées par Gemini en recevaient bien davantage : 100 par image, du plus probable au moins probable, sans seuil, jusqu’au printemps 2026. Les conversations partagées de cette période les gardent dans les données de leur page. Le vocabulaire est celui des modèles de vision de Google, quelle que soit l’image : passée dans l’API Vision, la photo d’un carton de déménagement reçoit le même /j/, Moving, que des images de Gemini. Dans ces listes, à côté des entités du Knowledge Graph, deux autres préfixes reviennent : /j/ pour une dimension, une zone ou une scène, /a/ pour une valeur. Cette couche sert au commerce, et elle se trouve dans le bas de la liste.
triés par score, sans seuil
relevés sur 67 499 images générées par Gemini
premiers labels ; 87 % en ont un dans les 100 premiers
Notre découverte
Sous les entités du Knowledge Graph, Google note les dimensions de l’objet (/j/) et leurs valeurs (/a/)
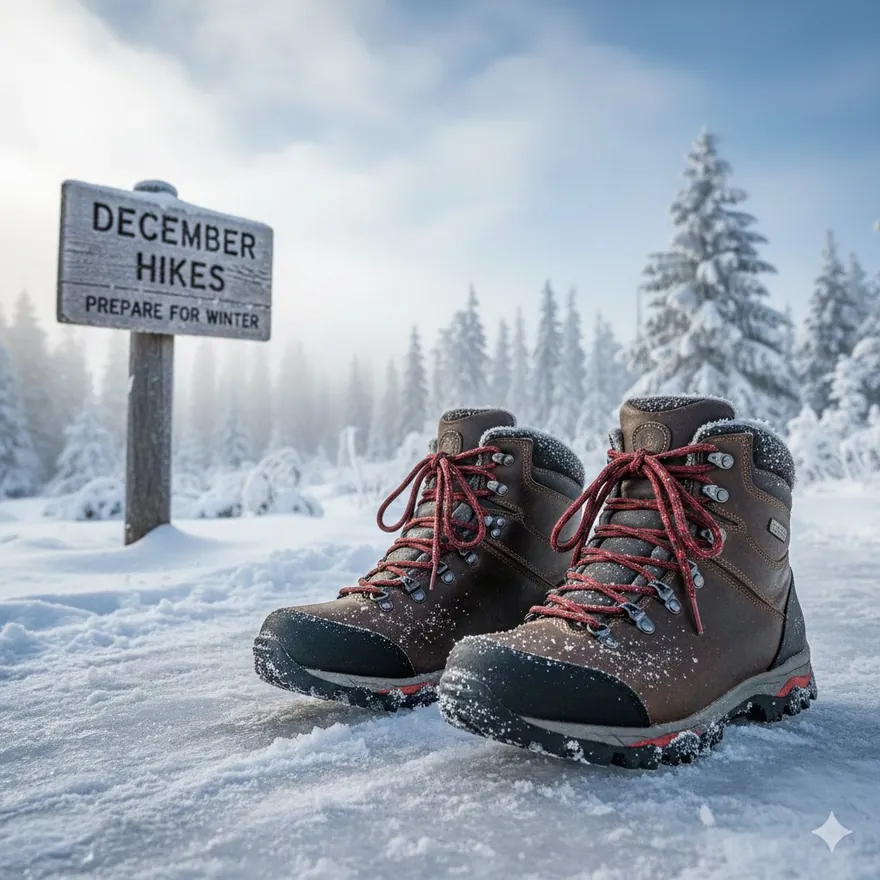
Reprenons les chaussures de randonnée du haut de page. Leurs dix premiers labels sont des entités du Knowledge Graph : Footwear, Snow, Shoe, Winter. Leurs MID commencent par /m/, le format de Freebase, la base rachetée par Google en 2010 qui a servi de socle au Knowledge Graph, ou par /g/, celui des entités créées depuis : ce sont les identifiants qui se trouvent derrière les knowledge panels. Plus bas arrivent For winter (22e), Lace up (43e), Shoe style (48e), puis For outdoor, Round toe et Rugged. Shoe style, en /j/, nomme une dimension ; Lace up et Round toe, en /a/, en sont des valeurs ; For winter, For outdoor et Rugged, en /a/ aussi, disent l’usage et l’allure.
| Préfixe | Ce que c’est | Ce qu’il dit de l’image | Exemples |
|---|---|---|---|
| /m/ | Entité du Knowledge Graph, au format de Freebase | ce que montre l’image | Sled dog/m/01p01nFalafel/m/015w3y |
| /g/ | Entité plus récente du Knowledge Graph | ce que montre l’image, plus finement | Tonkotsu ramen/g/11bwd90s52Avocado toast/g/11g6py19lr |
| /j/ | Dimension ou catégorie : type de zone, scène, geste, catégorie de contenu, dimension de produit | dans quel genre de situation, selon quel critère | Table top/j/984ysmSleeve style/j/6y5h45 |
| /a/ | Valeur ou attribut : coupe, longueur, matière, style, usage | comment est la chose | Long sleeve/a/dr73ssUndermount sink/a/8y6cck |
| /t/ | Identifiant tiré des pages, sans libellé : une référence produit, ou le thème que les pages donnent à une image | à quel produit ou à quel sujet du Web elle se rattache | iPhone 17 Pro/t/…exemple : libellé déduit des pages |
Un vocabulaire à part, branché sur le Knowledge Graph par endroits
Les /j/ et les /a/ ont la forme d’un MID, avec une suite de six caractères exactement, et appartiennent au vocabulaire des modèles de vision. Interrogé comme une entité, un /j/ ne renvoie qu’une erreur, là où un /m/ renvoie l’entité.
Ce second vocabulaire a sa hiérarchie, ses dimensions et leurs valeurs, et il se branche sur le Knowledge Graph par endroits : le code-barres est une entité, ses deux formes sont des /j/.
/m/0ggbx- 1D barcode
/j/8sk4f30,97code-barres linéaire - 2D barcode
/j/863wbw0,99code-barres 2D (QR code, Data Matrix)
Le code-barres est une entité du Knowledge Graph (/m/0ggbx). Ses deux formes sont des /j/ : 1D barcode, le code-barres linéaire, avec un score de 0,97 sur le dos d’un sachet ; 2D barcode, le QR code, 0,99. L’entité nomme l’objet, le /j/ la zone que Google Lens découpe dans la photo.
/j/5qg9b8produit emballé- Bagged packaged goods
/j/5wqldn0,72produit en sachet - Boxed packaged goods
/j/d0mdr60,70produit en boîte - Bottled and jarred packaged goods
/j/5pzgsf0,53produit en bouteille ou en bocal - Canned packaged goods
/j/1dkfcf0,75produit en conserve - Tubed packaged goods
/j/1971bm0,93produit en tube
Packaged goods chapeaute cinq conditionnements : sachet, boîte, bouteille ou bocal, conserve, tube. Sur des photos de produits isolés, l’API Vision les trouve tous les cinq, avec des scores de 0,53 à 0,93. Dans la table de Google Lens, ces six classes sont neutres ; Lens Lite, qui ne garde que 68 objets pour la recherche de produits, les retient toutes les six : il vise aussi les produits emballés de l’épicerie (notre étude des objets que Lens juge achetables).
/j/6y5h45style de manche- Short sleeve
/a/5m67kzmanche courte - Long sleeve
/a/dr73ssmanche longue - Half sleeve
/a/4x501ndemi-manche - Full sleeve
/a/g8fdrhmanche entière
Sleeve style est une dimension ; ses valeurs sont des /a/ : manche courte, longue, demi-manche, manche entière. Ce sont les valeurs du filtre « Sleeve Style » de Google Shopping : la section suivante les met côte à côte.
Une scène obtient un score élevé, et Google la classe comme décor
L’API Vision donne deux nombres par label : le score, la confiance que la chose est dans l’image, et la topicality, le poids du label dans le sujet de l’image. Elle mêle entités et /j/ dans une seule liste, triée par score. Prenons la photo d’un carton de déménagement ouvert : Package delivery (/m/, 0,83), puis Moving (/j/, 0,63), puis Relocation (/m/, 0,58). Le déménagement y figure deux fois, une fois dans chaque vocabulaire.
- 11Package delivery
/m/01d7430,83topicality 0,19 - 14Moving
/j/20b_h80,63topicality 0,015 - 17Relocation
/m/043rxy00,58topicality 0,42
API Cloud Vision, photo d’un carton ouvert : rang dans la liste des labels, score, topicality.
Moving a le meilleur score des deux, Relocation une topicality 29 fois plus forte. La règle se vérifie sur les 9 /j/ apparus parmi les labels des 34 photos que nous avons passées dans l’API : un /j/ obtient un score aussi élevé qu’une entité (médiane 0,76 contre 0,77) et une topicality huit fois plus faible. La plupart des labels ont une topicality proche de zéro ; seul le sujet de l’image atteint une topicality élevée. Sur une photo de plage, Beach (/m/) obtient un score de 0,98 et une topicality de 0,53 ; People on beach (/j/), à 0,84, n’a qu’une topicality de 0,0009. Google est sûr de la scène, et il sait qu’elle reste le décor.
Les /j/ décrivent aussi la mise en scène : une table dressée devient Wedding banquet, des animaux sur l’herbe Pet an animal, un carton Moving. Ils nomment des types de zone (Table top, Storefront, les emballages, les codes-barres) et des catégories de contenu sensible (Firearms, Nudity), modulées par le contexte : fiction, dessin animé, publicité, actualité. Les /a/ qualifient aussi le style et l’usage : Vintage, Luxury, For prom, For winter. Pour une photo produit, le décor apporte une occasion d’usage, avec une topicality faible : Google la garde comme contexte du sujet.
Le cinquième préfixe, /t/, vient des pages où paraît l’image et de la recherche. Sur les pages marchandes, un /t/ désigne une référence précise, avec son code-barres, la même chez tous les marchands qui la vendent. Dans la détection Web, la partie de l’API Vision qui lit les pages où figure une image, il désigne une famille de produits ou un thème. Il reste toujours sans libellé.
Les valeurs lues sur la photo sont celles des filtres de Google Shopping
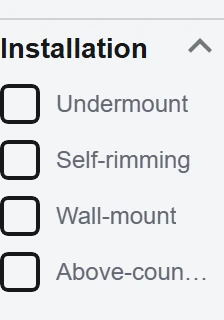
Prenons deux requêtes sur Google Shopping US : « dresses » et « bathroom sinks ». Dans la colonne des filtres, les robes se filtrent par « Sleeve Style » (Long Sleeve, Half Sleeve), « Silhouette », « Formal Occasion » ; les lavabos par « Installation » (Undermount, Self-rimming, Wall-mount) et « Style » (Vessel, Pedestal, Console). Les valeurs de ces filtres se retrouvent dans les /a/ que Google pose sur les photos (Long sleeve, Undermount sink, For prom), et « Sleeve Style » est aussi un /j/. Le /j/ joue le rôle du filtre, le /a/ celui de la case cochée.
À gauche, les filtres de Google Shopping (États-Unis) ; à droite, les labels correspondants que Google attache aux photos
Requête « dresses »
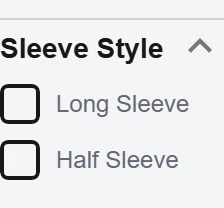 Sleeve style
/j/6y5h45style de mancheLong sleeve/a/dr73ssmanche longueHalf sleeve/a/4x501ndemi-manche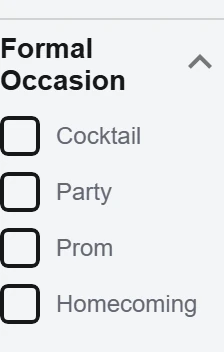 For prom
/a/bckrxlpour le bal de fin d’annéeFor homecoming/a/g6jk9wpour le bal de rentrée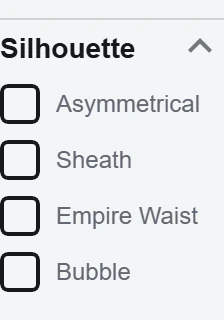 Asymmetrical
/a/42lnhnasymétrique
Requête « bathroom sinks »
 Sink type
/j/4fs9rdtype de lavaboUndermount sink/a/8y6cckvasque sous planSelf rimming sink/a/8dv91hvasque à encastrer par le dessusWall mount/a/g6jflsfixation murale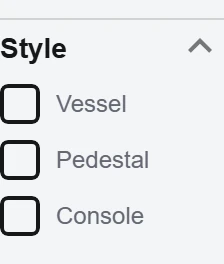 Vessel sink
/a/znv7b6vasque à poser
Les catégories où Google lit les caractéristiques du produit sur la photo
Certaines catégories de produits reçoivent bien plus de valeurs que d’autres. Sur les images générées par Gemini, la dimension Clothing length s’accompagne d’une longueur dans 90 % des cas, Sleeve style d’une valeur de manche dans 80 %, Shoe style d’un détail de chaussure dans 72 %. Furniture style, présent sur plus de mille images, n’a de valeur que dans moins de 1 % des cas. Ces écarts montrent pour quels produits Google juge les caractéristiques visibles sur la photo : les vêtements, les chaussures et les lavabos, bien plus que les meubles et les rideaux.
Quand Google voit la dimension, donne-t-il aussi une valeur ?
- Clothing length90 % 134 sur 149
- Sleeve style80 % 153 sur 192
- Shoe style72 % 43 sur 60
- Sink type56 % 15 sur 27
- Collar style54 % 21 sur 39
- Eyeglass style33 % 70 sur 215
- Curtain style2 % 1 sur 64
- Furniture style1 % 9 sur 1006
Montrer sur la photo ce que le filtre demande
Pour que Google lise la longueur d’une robe, montrez-la en pied ; pour la forme d’une manche, une manche entière ; pour le montage d’un lavabo, le bord de la vasque et le plan. Le flux produit et la photo donnent alors les mêmes valeurs, et l’un confirme l’autre. Notre infographie Google Shopping, de la SERP à AI Mode détaille les 82 filtres du catalogue et les scores qui les alimentent.
Quinze images et leurs 100 labels : ce que le seuil de 0,5 laisse de côté
Jusqu’au printemps 2026, chaque image générée par Gemini était accompagnée de 100 labels. Ces labels ne sont désormais plus visibles. Les conversations partagées à cette époque les gardent : les 67 499 images que nous avons étudiées viennent des conversations publiques de notre étude sur Gemini. Voici quinze conversations publiques, chacune avec son lien : choisissez une image, filtrez les labels par vocabulaire, placez le seuil sur 0,5 pour voir ce que l’API Vision garderait.
DIYLisez vous-même les labels d’une conversation partagée
Les quinze conversations, sur gemini.google.com/share/
- Chaussures de randonnée
46d214584453 - Sac à main brodé
0b6ea7e2534c - Boîte de lessive
be06d48c419f - Salle de bains
b4066d6a83f8 - Bol de ramen
985bca1fe462 - Saumon et légumes
8bfd3423058e - Spaghetti ail et piment
e1550278030b - Petit-déjeuner
b5dccea15173 - Salle de bal après la fête
bfbe1a0f7536 - Ville du futur
faf66e48a022 - Mont Fuji et érable
54dd5701b049 - Chats et chien
4dc927bbb7d9 - Arbre en crayons de cire
28fa8388d3d3 - Frein à main ancien
5d628c9eb35c - Trait en T
091288b1b7e3
Commencez par la Boîte de lessive : quatre /j/, dont Packaged goods. Sur Mont Fuji et érable et Frein à main ancien, cherchez « /a/ ». Les deux méthodes valent pour toute conversation partagée dont Gemini a généré les images avant le printemps 2026.
Sans code : l’onglet Réseau
Ouvrez une conversation dans Chrome, puis les DevTools (F12), onglet Réseau (Network). Tapez « ujx1Bf », le nom de l’appel qui charge la conversation, dans le filtre, puis rechargez la page : une seule ligne reste. Cliquez dessus, ouvrez l’onglet Réponse (Response) et cherchez « /j/ » avec Ctrl+F. Chaque label s’écrit [\"Table top\",\"/j/984ysm\",0.6248081] : libellé, MID, score.
En un copier-coller : la console
Sur la page de la conversation, ouvrez l’onglet Console des DevTools et collez ce code. La première fois, Chrome demande de taper « autoriser le collage » (« allow pasting » dans un Chrome en anglais). Le code relance l’appel ujx1Bf et affiche une ligne par label, du plus probable au moins probable, sous la forme ["Table top","/j/984ysm",0.6248081].
fetch('/_/BardChatUi/data/batchexecute?rpcids=ujx1Bf', {
  method: 'POST',
  headers: {'Content-Type': 'application/x-www-form-urlencoded;charset=UTF-8',
            'X-Same-Domain': '1'},
  body: 'f.req=' + encodeURIComponent(JSON.stringify([[['ujx1Bf',
    JSON.stringify([null, location.pathname.split('/').pop(), [4]]), null, 'generic']]]))
}).then(r => r.text()).then(t => console.log([...new Set(
t.replaceAll('\\"', '"').match(/\["[^"]+","\/[a-z]\/\w+",[\d.]+\]/g))].join('\n')))La démo de Google Vision donne les /j/ dans sa réponse brute
L’API Vision, le service d’analyse d’images que Google vend aux développeurs, emploie les mêmes /j/ que les images de Gemini : Table top, Bagged packaged goods, Playing in the snow. Chacune de ces douze photos libres de Wikimedia Commons en reçoit au moins un (en orange), sur une zone découpée de la photo ou sur l’image entière.
DIYRefaire le test en quatre étapes
- Téléchargez une des photos ci-dessus (lien « Télécharger la photo testée ») ou prenez la vôtre : JPEG, PNG, GIF ou BMP, moins de 4 Mo.
- Ouvrez la démo de Google Vision, descendez jusqu’au cadre « Try the API » et déposez le fichier.
- Cochez « I’m not a robot ». Les onglets Objects et Labels reprennent les deux colonnes de la visionneuse, avec les noms et les scores ; les identifiants sont dans le JSON.
- Cliquez sur « Show JSON » et cherchez « /j/ » : pour le sachet,
"mid": "/j/8sk4f3"se trouve à côté de"name": "1D barcode".
De Googlebot-Image à l’index : Google légende chaque image et la rattache à quelques pages
Googlebot-Image récupère l’image, Amarna, le système d’images de Google Search, réunit tout ce que les modèles y voient, puis Google la rattache à quelques pages et la répartit dans les cases que lisent les filtres de Google Images. Par rapport au leak de 2024, le code de Google auquel nous avons eu accès ajoute à ce que l’index garde d’une image tout ce qui touche à l’IA et à la sécurité : une légende rédigée par Google, ses entités, la provenance C2PA (les « Content Credentials » qui certifient l’origine d’une image), le refus de Google-Extended (le user-agent du robots.txt qui écarte un contenu de l’entraînement de Gemini et du grounding), un contrôle de protection de l’enfance. S’y ajoutent le cadre du sujet principal et l’image source parmi les copies.
- 1
Googlebot-Image récupère toutes les images
« Toutes les images sont crawlées par googlebot-images », écrit le leak. Google suit le crawl de toutes les copies d’une image comme un seul ensemble, avec la raison de chaque échec. Les règles robots.txt adressées à Googlebot-Image valent pour Google Images, Discover et toutes les fonctions de Google Search qui montrent des images.
ImageData.robotedAgentsrobots exclus par robots.txtImageMoosedogCrawlStateétat du crawl, par groupe de copies - 2
Amarna réunit tout ce que les modèles voient dans l’image
Amarna, le système qui stocke et analyse les images et les vidéos de Google Search, garde pour chaque image ses labels, ses visages, ses produits, le texte qu’y lisent en parallèle trois moteurs de reconnaissance de caractères (OCR), ses notes de qualité et de SafeSearch, son embedding, l’empreinte qui repère ses near duplicates et la probabilité qu’elle ait été générée par IA. Le texte lu sur un emballage sert aussi à relier la photo à la bonne fiche produit de Shopping.
OcrSummarytexte lu sur l’imageIm2ShopOCRFeaturetexte d’emballage relié à Shopping - 3
Google rédige une légende et liste les entités
Chaque image indexée reçoit une légende écrite par un modèle, avec son degré de confiance, et la liste des entités du Knowledge Graph reconnues, chacune avec son score. Le sujet principal est encadré, avec un cadre à part pour le visage et ses propres entités. Chaque label reçoit deux mesures de topicality et une note de ce qu’il révèle de l’image ; une partie des labels vient d’images visuellement proches.
packed_multiref_captionlégende rédigée par Googlepacked_multiref_entitiesentités reconnuescutoutcadre du sujet principalinformativeness_scorece que le label révèle de l’image - 4
Les copies sont groupées, classées et datées
Toutes les copies d’une image forment un groupe classé, où le rang 1 est la meilleure. Google garde pour tout le groupe la date du premier crawl et l’adresse de l’image source : publier l’original d’abord chez soi, c’est en être la source. Les cent sites qui reprennent une même photo de stock se disputent une seule place.
rankInNeardupClusterrang dans le groupe de copiescontentFirstCrawlTimepremier crawl du contenuimage_neardup_sourceimage source parmi les copies - 5
Google rattache l’image à un nombre fixe de pages ; sur les autres, elle est « rejetée »
Pour chaque image, Google retient un nombre fixe de pages référentes ; sur les autres pages qui l’affichent, l’image est dite « rejetée ». Il note si l’image est affichée dans la page ou seulement liée, garde le texte placé à côté, qui sert à faire défiler la page jusqu’à l’image quand le visiteur arrive de Google Images, et reconnaît un domaine d’images associé au site, un CDN ou un sous-domaine, quand le lien se vérifie dans la durée.
referrerDocidpage référenteisVisibleaffichée ou seulement liéenearbyTexttexte voisincodomainStrengthlien avec un domaine d’images associé - 6
Le refus de Google-Extended reste attaché à l’image
Google-Extended est le user-agent du robots.txt qui règle l’usage d’un contenu pour entraîner les modèles Gemini et pour le grounding. Pour chaque image, Google garde ce refus et son origine : le robots.txt, ou la page qui affiche l’image. Il y ajoute un statut de conformité au corpus commun où Google réunit les contenus que ses modèles d’IA peuvent utiliser, contrôlé à partir de ces mêmes pages. L’indexation dans Google Images reste du ressort de Googlebot-Image.
robots_policy_signalrefus de Google-Extendedeffective_google_extended_sourceorigine du refus : page ou robots.txtgcc_image_url_policy_signalsconformité au corpus commun - 7
Mustang prépare l’image pour l’affichage et les filtres
Mustang, le système qui répond aux requêtes à partir de l’index de Google Search, garde avec l’image ses visages et ses recadrages, prêts à l’affichage, et les « restricts » : les 86 cases que lisent les filtres de Google Images.
PrecomputedRestrictsles cases des filtres
Le classement d’une image dépend de ce qu’elle montre, de sa place dans la page et des clics
Prenons la requête « chaise scandinave ». Pour Google Images, la requête est aussi un vecteur : elle passe dans la partie texte de Starburst, le modèle d’embedding d’images de Google, qui la place dans le même espace que les images, où Google la compare directement à leurs vecteurs. Une chaise qui n’a pas l’allure scandinave s’éloigne de la requête dans cet espace, même avec un texte alt qui dit le contraire. Le contenu visuel, la qualité de l’image, sa place dans la page et les clics entrent chacun dans le classement.
Google compare la requête et l’image dans le même espace de vecteurs
Une version de Starburst est tirée de Gemini Embedding 2, le modèle d’embedding multimodal que Google a ouvert aux développeurs en mars 2026 (API Gemini, Vertex AI) : mesurer avec lui la proximité entre une requête et ses images donne une idée de ce que voit Google Images. Des modèles distincts récupèrent puis notent les images, pour une requête écrite et pour une requête qui mêle une photo et du texte (le multisearch) ; un encodeur de requêtes est réservé aux plats et aux boissons. Le leak de 2024 montre une autre mesure, sans doute l’ancien mécanisme, ou un mécanisme en train d’être remplacé : l’algorithme pamir (PAMIR, Passive-Aggressive Model for Image Retrieval) note le contenu de l’image pour chaque requête et en tire un multiplicateur. Il reprend un modèle publié en 2008 par David Grangier et Samy Bengio, qui classe des images pour une requête texte d’après leurs couleurs et leurs contours.
Dans le code de Google
StarburstVersion.GEMINI_EMBEDDING_V2_SEARCHla version de Starburst tirée de Gemini Embedding 2STARBURST_TEXT_V5_PLCla partie texte, qui encode la requêteIMAGEEMBED_MM_QUERY_RETRIEVAL_V1006récupérer pour une requête image + texteMCC_FOOD_AND_DRINK_QUERY_TOWERl’encodeur des requêtes de plats et de boissonsimageContentQueryBoostle multiplicateur par requête de pamir (leak)
Notée à l’indexation, la qualité de l’image aide aussi la page dans les résultats web
À l’indexation, chaque image reçoit deux notes NIMA (Neural Image Assessment, un modèle publié par Google Research) : l’une esthétique, l’autre technique.
Dans la recherche web aussi, les images d’une page sont accompagnées de leur saillance, c’est-à-dire leur importance dans la page, leur pertinence estimée, de 0 (hors sujet) à 1 (très utile), et trois notes : qualité technique, qualité émotionnelle et capacité à retenir l’attention (DImE, Deep Image Engagingness). Un twiddler de la recherche web, une fonction qui réordonne les résultats après le classement, les lit pour faire monter la page qui les affiche.
Dans le leak de 2024
nimaAva · nimaVqnotes NIMA esthétique et techniquesalience · estRelevanceplace dans la page, pertinence estiméetqStar · eqStar · dimeScorequalité technique, émotionnelle, engagement
NavBoost classe aussi les images d’après les clics et repère les aimants à clics
NavBoost, la mémoire des clics de Google Search, existe aussi pour les images : pour une requête, il donne le rang de l’image d’après les clics et le rang de la page qui l’affiche. Les survols et les clics rapportés aux impressions mesurent l’attrait de la vignette. Une note d’« aimant à clics » repère l’image qui attire des clics depuis des requêtes sans rapport : chaque clic hors sujet la pénalise.
Dans le leak de 2024
ImageExactBoostNavQuery.imageClickRankrang de l’image d’après les clics, pour la requêteimageQualityClickSignalsclics et survols rapportés aux impressionsclickMagnetScorela note d’aimant à clics, pour les requêtes sans rapport
Orbit classe chaque image : personne, animal, mème, symbole haineux, visages
Orbit, le classifieur de Google Search qui trie les pages par intention (notre infographie sur l’intention de recherche), classe aussi chaque image pour elle-même : une personne, un animal, un mème, un symbole haineux, des visages visibles. La page qui publie l’image est une entrée facultative. Une classe s’applique dès l’indexation, ou seulement quand Google assemble la page de résultats. Elle peut déclencher un traitement ou retirer l’image d’un résultat : un mème ou un symbole haineux est repéré avant toute requête.
Dans le code de Google
ImageIntent.Intentpersonne, animal, mème, symbole haineux, visages visiblesOrbitImageIntent.InputTypel’image seule, ou l’image et sa pageOrbitImageIntent.Reachà l’indexation, ou à l’assemblage des résultatsOrbitImageIntent.trigger · removela classe déclenche un traitement, ou retire l’image
Pour les images, Google écarte d’abord, puis classe
RankLab, la plateforme où Google enregistre ses signaux de classement pour chaque requête et chaque résultat, garde pour les images leurs propres signaux : la voie par laquelle l’image a été trouvée (index texte, embedding, images voisines), ce que fait l’utilisateur après la recherche, les clusters d’intention du pack d’images, les suggestions insérées dans la grille. Dans les données d’un résultat d’image, les scores « de filtre » sont séparés des autres : Google écarte d’abord les images, puis classe celles qui restent.
Pour illustrer un lieu, Google préfère une photo grande, en paysage, fidèle au nom
Pour choisir la photo qui représente un lieu, Google note chaque candidate : qualité visuelle, photo plutôt que dessin, taille, format paysage, doublons, accord avec le nom du lieu et avec l’entité cherchée, labels reconnus, réputation du photographe. Un rang manuel peut trancher. Une photo grande, en paysage, distincte des autres et fidèle au nom a donc plus de chances d’être retenue.
Les 19 critères, dans le code de Google
ARGYLE_VISUAL_QUALITY_SCOREqualité visuelle (modèle Argyle)IS_PHOTO_SCOREphoto plutôt que dessinVALID_PHOTO_SCOREphoto valideIMAGE_SIZE_SCOREtailleLANDSCAPE_PREFERRED_SCOREformat paysage préféréNEAR_DUPLICATE_PHOTO_SCOREnear duplicateNAME_MATCH_CONTENT_SCOREaccord avec le nom du lieuPAMIR_NAME_MATCH_CONTENT_SCOREaccord du contenu visuel avec le nom (pamir)QUERY_TO_ENTITY_SCOREaccord avec l’entité cherchéeQUERY_TO_KFT_SCOREaccord avec la requête, mesuré par un autre modèle (KFT)ICA_LABEL_SCORElabels de l’annotation d’image (ICA, Image Content Annotation)ICA_CONTENT_SCOREcontenu reconnu par l’annotation d’image (ICA)WEB_REF_CONTENT_SCOREentités tirées des pages (Webref)PHILEAS_CONTENT_SCOREcontenu jugé par un autre système de reconnaissance (Phileas)SALT_MATCH_SCOREcorrespondance selon un autre système de reconnaissance (SALT)VDICT_SCOREnote d’un dictionnaire visuel (VDICT pourrait correspondre à visual dictionary)CONFUSION_SCORErisque de confusionTOP_PHOTOGRAPHER_SCOREmeilleurs photographesMANUAL_RANKrang manuel
Les filtres de Google Images lisent 86 cases remplies à l’indexation
Avant qu’une recherche arrive, Google a déjà classé chaque image dans des cases : couleur, type, visages, proportions, taille, format, licence, SafeSearch. Le leak de 2024 nomme ces « restricts », calculés avant la construction de l’index qui sert les résultats ; le code de Google que nous avons récupéré en donne la liste : 86 cases. Le filtre juge le fichier lui-même : ses dimensions réelles, son format, ses couleurs, sa licence déclarée.
Couleurs 15
Les douze pastilles du filtre Couleur, le noir et blanc, la couleur.
COLOR_BLACKnoirCOLOR_BLUEbleuCOLOR_BROWNmarronCOLOR_GRAYgrisCOLOR_GREENvertCOLOR_ORANGEorangeCOLOR_PINKroseCOLOR_PURPLEvioletCOLOR_REDrougeCOLOR_TEALturquoiseCOLOR_WHITEblancCOLOR_YELLOWjauneMONOnoir et blancCOLORen couleurTOLERANT_GRAYgris, avec tolérance
Type d’image 9
Photo, dessin, animation, et la photo de banque d’images, repérée comme telle.
PHOTOphotoCLIPARTclipartLINEARTdessin au traitANIMATEDanimée (GIF)TRANSPARENTfond transparentCLIPART_HRclipart, variante HRPANORAMICpanoramaPORTRAITportraitSTOCKphoto de banque d’images
Visages 6
Le nombre de visages et le genre apparent, calculés d’avance. L’écran propose un type « Visages », sans nombre ni genre.
FACES_ONEun visageFACES_TWOdeux visagesFACES_SEVERALquelques visagesFACES_MANYbeaucoup de visagesFACE_MALEvisage d’hommeFACE_FEMALEvisage de femme
Proportions 9
Neuf proportions ; l’écran en regroupe cinq sous quatre choix.
_image_aspect_tallportrait_image_aspect_xtalltrès haut_image_aspect_squarecarré_image_aspect_widepaysage_image_aspect_xwidepanoramique_image_aspect_16x1016:10_image_aspect_16x916:9_image_aspect_4x34:3_image_aspect_nearsquarepresque carré
Taille 28
Dix-sept seuils « plus grande que », jusqu’à 140 mégapixels, et des classes de taille.
_image_size_atleast_400x300≥ 400×300_image_size_atleast_640x480≥ 640×480_image_size_atleast_800x600≥ 800×600_image_size_atleast_1024x768≥ 1024×768_image_size_atleast_1280x800≥ 1280×800_image_size_atleast_1440x900≥ 1440×900_image_size_atleast_2MP≥ 2 Mpx_image_size_atleast_4MP≥ 4 Mpx_image_size_atleast_6MP≥ 6 Mpx_image_size_atleast_8MP≥ 8 Mpx_image_size_atleast_10MP≥ 10 Mpx_image_size_atleast_12MP≥ 12 Mpx_image_size_atleast_15MP≥ 15 Mpx_image_size_atleast_20MP≥ 20 Mpx_image_size_atleast_40MP≥ 40 Mpx_image_size_atleast_70MP≥ 70 Mpx_image_size_atleast_140MP≥ 140 MpxICONicôneMEDIUMmoyenneLARGEgrandeSMALLpetiteXLARGEtrès grandeXXLARGEXXL_imagehugeénormeBEST« best »_image_size_iconicône_image_size_smallpetite_image_size_mediummoyenne
Format de fichier 9
Neuf formats ; HEIF, le conteneur de l’AVIF, reste hors de l’écran.
FILETYPE_JPGJPGFILETYPE_GIFGIFFILETYPE_PNGPNGFILETYPE_BMPBMPFILETYPE_SVGSVGFILETYPE_WEBPWebPFILETYPE_ICOICOFILETYPE_CRAWRAW d’appareil photoFILETYPE_HEIFHEIF
Droits d’usage 2
Le filtre « Droits d’usage », lu dans la licence déclarée.
CC_LICENSElicences Creative CommonsNON_CC_LICENSElicences commerciales et autres
SafeSearch 5
Une case « contenu pour adultes » et ses trois niveaux de filtrage, une case violence : le réglage SafeSearch du compte s’appuie sur elles.
_img_porn_moderateadultes, filtrage modéré_img_porn_strictadultes, filtrage strict_img_porn_very_strictadultes, très strictPORNcontenu pour adultesVIOLENCEviolence
Divers 3
Les voisines visuelles, et l’image exclue du pack d’images des résultats web.
HAS_SIMILARa des images similairesNOT_UNIVERSALhors du pack d’images des résultats webALLtoutes les images
Visages, genre apparent, photo de stock : Google les calcule pour chaque image
Google compte les visages de chaque image, note leur genre apparent et repère la photo de stock ; Google Images, lui, propose un seul type « Visages ». La recherche avancée d’images propose quatorze seuils de taille, jusqu’à 70 mégapixels, quatre proportions et huit types de fichier ; le code prévoit dix-sept seuils jusqu’à 140 mégapixels, neuf proportions (16:9, 4:3, presque carré…) et une case HEIF, le conteneur de l’AVIF ; Search Central compte l’AVIF parmi les formats indexés. Toutes ces cases sont remplies avant la recherche, qu’un filtre public les lise ou non.
Le filtre Couleur sépare l’objet du fond, de la peau et des visages
Pour le filtre Couleur, Google distingue la couleur du premier plan de celle du fond et pondère à part la bordure, la peau et les visages : un pull rouge porté par un mannequin reste un pull rouge. Les douze couleurs du code sont exactement les douze pastilles du filtre.
SafeSearch : l’image hérite de la note des pages qui l’affichent, le site de celle de ses images. Le leak décrit la note d’une image comme la combinaison de ses pixels, des requêtes d’où viennent ses clics et des pages qui l’affichent, near duplicates compris : une photo de maillot de bain reprise par des sites pour adultes est classée comme eux. Un site a aussi ses propres taux : sa part de contenus pour adultes, et la violence moyenne de ses images et de ses vidéos.
AI Mode puise ses images dans Google Images, et repère les réponses qui en manquent
Quand on lui soumet une photo, AI Mode s’appuie sur Google Lens, la recherche visuelle de Google, pour identifier chaque objet, puis lance des requêtes sur l’image entière et sur chacun de ses objets : c’est le fan-out appliqué à l’image, le « visual search fan-out », qui découpe une seule photo en dizaines de sous-requêtes. Nous vous expliquons ici comment AI Mode cherche et note les images de ses réponses.
Dans AI Mode, les images sont notées comme des résultats
Mars, le serveur qui produit les réponses de la recherche par IA de Google (AI Mode, Ask Maps…), a son propre parcours de recherche d’images, avec des signaux de classement pour chaque résultat. Les images d’une réponse sont des documents de Google Images : quand un utilisateur signale une image fausse, hors sujet, protégée par le droit d’auteur ou de mauvaise qualité, le signalement pointe vers l’image indexée. Quatre des critères qui servent à évaluer les réponses générées portent sur les images : la question appelait-elle des images, la réponse en manquait-elle, en a-t-elle montré à tort, l’image montrée est-elle mauvaise.
Dans le code de Google
MarsImageSearchRanklabResultSignalsles signaux de classement que Mars enregistre dans RankLab, la plateforme des signaux de chaque résultatMagiFeedbackContext.image_doc_idsles images signalées dans les réponses de magi, le nom de code de l’IA dans les résultats (AI Overviews, AI Mode), par leur identifiant dans Google ImagesVISUAL_SEEKING · LACK_OF_VISUALS · VISUAL_WRONG_TRIGGERING · BAD_VISUALquestion qui appelle des images, réponse qui en manque, images montrées à tort, mauvaise image
Lens distingue la photo d’un écran de l’objet lui-même
Lens, qui traite plus de 25 milliards de recherches visuelles par mois, sait si on lui montre un objet, la photo d’un écran ou une capture d’écran, et choisit ses formats de résultats en conséquence : produits, correspondances visuelles, correspondances exactes, devoirs, vidéos, « À propos de cette image ». Pour chaque objet découpé, Google choisit de ne rien afficher, d’afficher le cadre, ou le cadre et son nom : c’est la mécanique de « rechercher dans l’image ». Nos deux études détaillent ce que voit Google Lens et les objets qu’il juge achetables.
Dans le code de Google
MEDIUM_PHOTO_OF_SCREEN · MEDIUM_PHYSICAL · MEDIUM_SCREENSHOTphoto d’un écran, objet, capture d’écranRESULT_FORMAT_ID_VISUAL_EXACT_MATCHESles correspondances exactes, qui mènent aux pages où paraît la même imageImageRegion.RenderTyperien, le cadre, ou le cadre et son nom
Image générée ou non : Google croise filigrane, empreinte et métadonnées, et sait s’abstenir
« À propos de cette image » dit si une image a été créée ou retouchée avec l’IA, à partir de SynthID, le filigrane invisible que Google DeepMind inscrit dans les pixels au moment de la création, et des métadonnées C2PA (Coalition for Content Provenance and Authenticity), le standard des « Content Credentials ». Plus de 20 milliards de contenus sont marqués du filigrane SynthID (novembre 2025).
Faute d’indice net, Google s’abstient de dire si l’image est générée
La détection combine quatre indices : le filigrane SynthID, une recherche par empreinte parmi les images que les modèles de Google ont générées, les métadonnées C2PA et IPTC (International Press Telecommunications Council, le standard de métadonnées photo né dans les agences de presse), et une mention « IA » visible sur l’image, qu’un détecteur repère. Le verdict a cinq valeurs : accepter (l’image est jugée générée), accepter en repli, s’abstenir, rejeter, rejeter en repli. SynthID s’abstient quand le fichier est vide, trop petit, de mauvaise qualité ou peut-être altéré. Le verdict d’ensemble devient plus exigeant pour une image de basse résolution ou éloignée des images que le modèle connaît : il faut alors un indice plus net pour conclure.
Dans le code de Google
GeneratedImageLikelihoodQueryResult.Decisionaccepter (l’image est jugée générée), accepter en repli, s’abstenir, rejeter, rejeter en repliGeneratedImageLikelihoodQueryResult.DecisionVersionverdict plus exigeant pour une image de basse résolution ou éloignée des images que le modèle connaîtFingerprintSearchResult.Decisiongénérée par Google, ou nonSynthIDResponse.AbstentionReasonfichier vide, basse résolution, mauvaise qualité, altération possibleSynthIDResponse.ImagePrevalenceà quel point l’image circule
L’index garde l’origine de chaque image signée et chacune de ses retouches
Dans l’index, l’image garde sa vérification C2PA : le signataire, son niveau d’assurance, la nature de l’image (prise de vue réelle, créée par l’IA, composition…) et chacune de ses retouches. Recadrage, couleur, suppression d’un élément, stylisation : chaque retouche existe en trois versions, faite avec un outil d’IA générative, sans, ou avec un outil « possiblement » fondé sur l’IA. Une photo produit dont on a supprimé le fond ou effacé un élément avec un outil d’IA garde cette trace dans l’index, et « À propos de cette image » s’appuie sur elle pour dire que l’image a été retouchée avec l’IA.
Prise de vue réelle
- prise de vue réelle
REAL_LIFE_CAPTURE - assemblage de prises de vue
REAL_LIFE_STITCHED_CAPTURE - améliorée sans IA générative
REAL_LIFE_CAPTURE_WITH_IN_LINE_NON_GENAI_ENHANCEMENTS
Créée par l’IA
- en partie générée
PARTLY_GENAI_CREATION - entièrement générée
FULLY_GENAI_CREATION
Peut contenir de l’IA
- composition
COMPOSITION_WHICH_MAY_CONTAIN_GENAI_CONTENT - art numérique
DIGITAL_ART_WHICH_MAY_CONTAIN_GENAI_CONTENT - capture d’écran
SCREEN_CAPTURE_WHICH_MAY_CONTAIN_GENAI_CONTENT
Autres
- création numérique sans IA
NON_GENAI_DIGITAL_CREATION - provenance inconnue
MEDIA_OF_UNKNOWN_PROVENANCE - fichier vide
BLANK_FILE
Dans l’IPTC, Google lit l’origine IA et la licence. Le champ Digital Source Type déclare une image générée (trainedAlgorithmicMedia), composite ou retouchée par l’IA. Google y lit aussi le type de licence (Creative Commons, droits gérés, libre de droits, éditorial seul, microstock), qui alimente le filtre « Droits d’usage », et les autorisations du modèle et du propriétaire (model release, property release). La documentation de Google précise qu’en cas de désaccord entre IPTC et données structurées, les données structurées l’emportent.
Pour le SEO : montrer le sujet, publier l’original, servir le fichier en grande taille, métadonnées comprises
Une image se travaille comme une page : ce qu’elle montre, son fichier, la page qui l’affiche et les clics qu’elle reçoit comptent chacun à leur étape.
Montrer ce que la requête et les filtres demandent
Google compare la requête au contenu visuel, avec Starburst, son modèle d’embedding d’images, et pamir, sa note de contenu visuel par requête ; avec Gemini Embedding 2, ouvert aux développeurs, vous mesurez cette proximité entre vos requêtes et vos images. Un packshot net, produit entier sur fond neutre ou transparent, donne sa classe d’emballage ; un rayon n’en donne aucune. Montrez en entier ce que le filtre demande : la longueur d’une robe, la manche, le bord d’une vasque. Une photo en situation ajoute l’occasion (mariage, déménagement, plage) sans prendre la place du sujet : Google la garde comme décor.
Publier l’original chez soi, en premier
Google garde pour tout le groupe de copies d’une image la date du premier crawl et l’adresse de l’image source : publier l’original d’abord chez soi, c’est en être la source. Google repère aussi la photo de stock comme telle, et cent sites qui publient la même photo se disputent une seule place. Un marchand qui fournit ses fiches produits à des revendeurs par flux XML, ou un éditeur qui syndique ses contenus, a intérêt à laisser quelques minutes entre la mise en ligne sur son site et l’envoi aux autres : Google découvre alors les images chez lui en premier.
Afficher l’image dans la page, grande, près du texte qui en parle
Google indexe les images des balises
<img>et note si l’image est affichée dans la page ou seulement liée. La saillance et la pertinence estimée de l’image comptent jusque dans le classement web. Search Central conseille de placer l’image près du texte qui en parle ; Google garde ce texte avec l’image.Faire dire la même chose à l’alt, à la légende de la page et à l’image
Google rédige sa propre légende pour chaque image et y joint les entités qu’il reconnaît ; il croise l’alt, la vision par ordinateur et le texte de la page. Un alt qui décrit ce que montre l’image renforce cette lecture.
Servir un fichier qui répond aux critères des filtres
Les filtres s’appuient sur le fichier lui-même : ses vraies dimensions, ses proportions, son format, sa transparence, sa licence. Servez l’original en grande taille et déclarez sa licence en données structurées ou en IPTC pour le filtre « Droits d’usage » et le badge « Licensable ».
Une vignette qui donne envie, sans racoler
NavBoost, la mémoire des clics de Google Search, mesure l’attrait de la vignette requête par requête : survols et clics rapportés aux impressions. Une image qui attire des clics depuis des requêtes sans rapport est repérée comme « aimant à clics ». Un visuel lisible en petit format et fidèle à la requête gagne sur les deux tableaux.
Garder la provenance, régler Google-Extended sur l’hôte des images
Pour vérifier l’origine d’une image, Google examine le fichier : un CDN qui retire les métadonnées efface le C2PA et l’IPTC, les données qui disent d’où vient l’image ; une image trop réduite fait s’abstenir SynthID, le filigrane de Google. Google garde pour chaque image le refus de Google-Extended, le user-agent du robots.txt qui écarte un contenu de l’entraînement de Gemini et du grounding, avec sa source : le robots.txt, ou la page qui affiche l’image. Un robots.txt vaut pour un seul hôte : pour qu’un CDN ou un sous-domaine d’images suive la règle du site, posez-la aussi dans leur robots.txt.
Restaurants et hôtels : nommer les plats, soigner la photo du lieu
Un menu complet dans Google Business Profile donne leurs noms aux photos des clients, et les noms saisis par le commerçant priment sur ceux des clients. Pour la photo d’un lieu, Google préfère une image grande, en paysage, distincte des autres et fidèle au nom.