Dater l'entrée d'une entité dans le Knowledge Graph de Google, et le codec original des MID
Les identifiants /g/11… sortent d'un compteur unique, commun à toutes les entités. Calé sur près de 27 000 entités datées par Wikidata, il donne le mois d'entrée d'une entité, à trois mois près dans 85 à 96 % des cas selon la tranche. Le second outil applique le codec original de Google, reconstruit, pour passer d'un MID à l'entier de 64 bits qui le code, et inversement.
Chaque entité du Knowledge Graph de Google porte un identifiant, le MID : /m/… pour celles héritées de Freebase, /g/… pour celles que Google a créées lui-même. En observant des dizaines de milliers d'identifiants, nous avons constaté que les /g/11… sont distribués dans l'ordre du temps par un compteur commun aux lieux, personnes, œuvres, marques, produits et événements.
Il suffit alors de connaître la date de quelques milliers d'entités pour lire celle de toutes les autres. La date obtenue est celle de l'entrée dans le Knowledge Graph : utile pour savoir depuis quand Google reconnaît une marque, une personne ou un produit, et pour repérer les vagues de création d'entités.
L'outil
Un nom d'entité, un MID ou une URL Google contenant kgmid= : l'outil rend le mois d'entrée estimé, un intervalle et la précision à en attendre.
Huit caractères en base 32 forment un nombre qui grandit avec le temps.
Un MID récent s'écrit /g/11 suivi de huit caractères, par exemple /g/11k4jj7mq1. Ces caractères viennent d'un alphabet de 32 symboles, 0123456789bcdfghjklmnpqrstvwxyz_, sans voyelles pour qu'aucun mot ne s'y forme. Le premier 1 désigne l'espace /g/ ; le reste, lu en base 32, donne un nombre compris entre 240 et 241 pour tous les /g/11…. C'est ce nombre qui grandit avec le temps.
Nous avons converti en nombres les MID de 95 647 entités datées par Wikidata, réparties en dix familles : événements, albums, films, jeux, élections, compétitions sportives, organisations, produits, lieux créés et lieux ouverts. Chaque famille a été datée à partir des neuf autres seulement, et toutes suivent la même courbe. À l'année près, l'estimation est juste pour 93 % des événements imprévisibles, 81 % des albums, 76 % des films, 67 % des jeux et 46 % des organisations.
événements imprévisibles (date au jour)singles et albums (échantillon)série lente de /g/11k à /g/11p
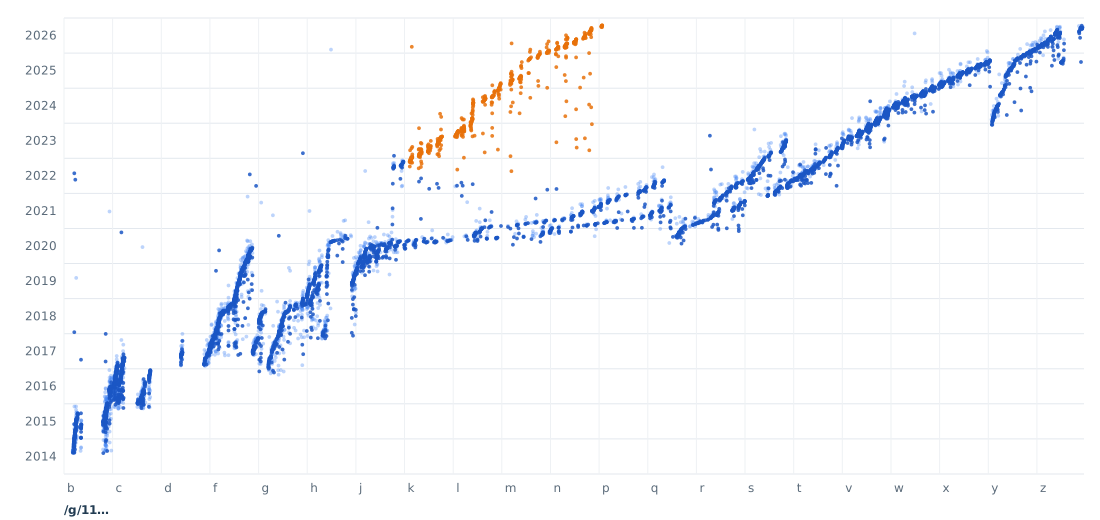
Chaque point est une entité de référence : en abscisse, la position de son MID entre /g/11b… et /g/11z… (la lettre qui suit /g/11) ; en ordonnée, sa date dans Wikidata. 7 876 points sur 26 815. Les points isolés sous la courbe sont des entrées tardives : une chose ancienne qui reçoit son MID des années plus tard.
~4 M
MID par jour en 2015-2016
~15 M
par jour en 2017-2020
30-270 M
par jour depuis 2020
3 h à 1 jour
suffisent depuis 2021 pour attribuer 33 millions de MID
Plusieurs séries en parallèle
Le compteur n'avance pas d'un seul bloc. Plusieurs séries d'attribution progressent en même temps, chacune dans ses propres plages d'identifiants. Dans une série, la date croît avec le MID ; d'une plage à l'autre, elle peut revenir en arrière. C'est le motif en dents de scie des tranches /g/11f à /g/11h, et les deux lignes superposées de /g/11k à /g/11p, décrites plus bas.
La méthode
Pour un MID, on prend les références datées les plus proches de part et d'autre, on garde celles de la même période et on lit la date sur une courbe tracée à travers elles. Les références sont des événements imprévisibles, des singles et des albums datés par Wikidata. L'intervalle annoncé reprend l'erreur mesurée dans la même tranche : 79 à 87 % des événements testés y tombent.
Précision par tranche
Au mois dans presque toutes les tranches, jamais sous la semaine : un événement reçoit en général son MID une à deux semaines après sa survenue. La zone /g/11k-/g/11n, partagée par deux séries, reste la moins sûre.
Tranche
Années d'attribution
Erreur médiane
±1 mois
±3 mois
±6 mois
Précision conseillée
/g/11b - /g/11d
2014-2017
5 jours
82 %
92 %
96 %
au mois
/g/11f - /g/11h
2017-2020
6 jours
78 %
90 %
93 %
au mois
/g/11j
2020
8 jours
78 %
94 %
98 %
au mois
/g/11k - /g/11n
2020-2026, deux séries
6 jours
77 %
85 %
89 %
au mois si la série est reconnue, sinon au trimestre
/g/11p - /g/11t
2021-2024, série lente dans /g/11p depuis septembre 2026
5 jours
85 %
93 %
97 %
au mois
/g/11v - /g/11z
2024-2026
5 jours
87 %
96 %
98 %
au mois
4 662 événements datés sans eux-mêmes, avec le MID donné par Wikidata ou celui que Google affiche aujourd'hui, pondérés selon la situation réelle des MID (bloc de 33 millions avec ou sans référence). Sur les MID affichés par Google, l'outil est à ±3 mois dans 82 % des cas en /g/11k-n et 93 % en /g/11p-t.
Au bord du compteur. Les références s'arrêtent au 22 octobre 2026. Un identifiant attribué après cette date, donc en pratique à partir de novembre 2026, tombe au-delà : l'outil le date en prolongeant le compteur. En recalant l'outil à des dates passées, nous avons mesuré que, pour la série principale, il reste à ±3 mois pour 98 à 100 % des événements des deux mois qui suivent (ici jusqu'à fin décembre 2026), puis pour 82 % au troisième mois (janvier 2027). Pour la série lente, rien ne signale qu'elle entre dans un nouveau bloc : la bonne date figure dans la réponse, souvent en seconde position, jusqu'à ce que les références soient mises à jour.
La série lente de /g/11k à /g/11p
Une première série a rempli /g/11k à /g/11p en 2020-2022. Une seconde, plus lente, occupe depuis fin 2022 les plages qu'elle avait laissées libres : ce sont les points orange du graphique, deux à cinq ans au-dessus des points bleus. Partie de /g/11k, elle est entrée dans /g/11p fin septembre 2026. Un identifiant isolé de cette zone peut donc dater de 2021 comme de 2026.
Tranche
Série rapide
Série lente
/g/11k…
juillet à octobre 2020
décembre 2022 à août 2023
/g/11l…
septembre 2020 à février 2021
septembre 2023 à décembre 2024
/g/11m…
octobre 2020 à mars 2021
février 2025 à février 2026
/g/11n…
décembre 2020 à août 2021
mai 2025 à août 2026
/g/11p…
mars 2021 à février 2022
depuis septembre 2026
Dates des références de chaque série, du 10e au 90e percentile.
Les deux séries se mélangent rarement dans un même bloc de 33 millions d'identifiants : 837 blocs sur les 891 qui contiennent au moins deux références datées appartiennent à une seule série. L'outil reconnaît la série au bloc de l'identifiant ou à ses voisins. Quand les blocs voisins se contredisent, il place la série lente en premier et donne la date de la série rapide en second : la série lente était la bonne pour 86 % des événements de référence dans ce cas. Quand la série rapide est déduite des voisins, il donne aussi la date de la série lente, car celle-ci entre sans prévenir dans des blocs restés libres.
Le codec original : convertir un MID en entier, et inversement
Dans le code de Google, un MID est un entier de 64 bits. L'outil passe d'une écriture à l'autre, et lit aussi les anciens GUID Freebase.
version (2 bits, toujours 0) + espace de noms (3 bits)valeur, 5 bits par caractèrezéros de tête, que Google n'écrit pas
Espace de noms
/m/graphe 0
Entier Google
405850x0000000000009e89
Valeur (59 bits)
40585≈ 215,3
GUID Freebase
#9202a8c04000641f8000000000009e89
Identifiant hérité de Freebase. Le compteur est figé depuis la fermeture de Freebase : aucun /m/ ne dépasse le dernier GUID (/m/013fcqbq). Deux sujets reçoivent rarement des numéros voisins, parce que ce compteur numérotait aussi les liens entre objets.
Le code de Google lit un MID comme un entier de 64 bits en trois parties : 2 bits de version, toujours à 0, 3 bits pour l'espace de noms (le « graph ID » du code), puis 59 bits de valeur. La chaîne s'écrit avec le préfixe de l'espace (/g/), un caractère qui porte la version et l'espace, puis la valeur en base 32 sans zéro de tête, dans l'alphabet que le code appelle « munch ». C'est pour cela que tous les /m/ commencent par 0 et tous les /g/ par 1 : ce premier chiffre n'appartient pas au compteur.
version (2 bits, toujours 0) + espace de noms (3 bits)valeur, 5 bits par caractèrezéros de tête, que Google n'écrit pas
Pour /g/11b6377dzp : 259 pour l'espace /g/, plus 1b6377dzp lu en base 32 (1 449 659 708 373), soit 576462201963131861. C'est l'entier que Valentin Pletzer avait relevé en 2019 dans une URL de recherche Google (ibp=tpf;cl_tp:srp,mid:576462201963131861). Ce MID désigne « Public prosecutor's office ».
Graphe
Préfixe
1er caractère
Ce qu'on y trouve
0
/m/
0
Entités héritées de Freebase. Compteur figé : 330 825 valeurs observées, toutes sous le dernier GUID Freebase.
1
/g/
1
Entités créées par Google. Compteur attribué par blocs, souvent homogènes : lieux, chansons, adjectifs.
2
/t/
2
Plusieurs usages observés : produits sur les sites marchands, sujets d'images (une famille à part), groupes d'entités qu'un même mot peut désigner (« allemand » : Allemagne, langue allemande, Allemands), anciens thèmes d'intérêt k'nex (/t/236, Tennis). Point commun probable : des entités fabriquées à côté du graphe. 59 bits uniformes : pas un compteur.
3 à 5
/x//n//p/
3 à 5
Prévus par le code, jamais observés.
6 et 7
/r//s/
-
Réservés, jamais observés.
Le code de Google, reconstitué
Le fichier source metaweb/util/mid/mid.cc n'est pas public. Son chemin rappelle l'origine du codec : Metaweb, la société qui avait créé Freebase avant d'être rachetée par Google en 2010. Nous avons mis la main sur le binaire du codec original et l'avons reconstruit en C++. La logique, les constantes, les messages et les numéros de ligne sont ceux du binaire. Les noms de fonctions et de variables sont les nôtres : le binaire n'en contient plus.
// metaweb/util/mid/mid.cc                                     // reconstitution : la logique est celle du binaire, les noms sont les nôtres
static const char kMunch[] = "0123456789bcdfghjklmnpqrstvwxyz_";
static const string_view kPrefix[8] = {"/m/", "/g/", "/t/", "/x/", "/n/", "/p/", "/r/", "/s/"};
static const uint64_t kMaxValue = 0x7ffffffffffffff;           // 2^59 - 1

uint64_t MakeMid(int graph, uint64_t value) {
  if (value >> 59) {
    VLOG(1) << "Mid exceeds max size 0x" << hex << kMaxValue   // ligne 226 du fichier source
            << " for namespace " << kPrefix[graph] << ": 0x" << value;
    return -1;
  }
  if (graph == -1) return -1;
  return value | (uint64_t(graph) << 59);
}

bool ParseMunch(string_view s, uint64_t* out) {
  if (s.size() > 13) return false;
  if (s.size() == 13 && kMunchValue[s[0]] > 15) return false;  // dépasserait 64 bits
  uint64_t v = 0;
  for (char c : s) {
    int d = kMunchValue[c];                                    // -1 hors alphabet
    if (d < 0) return false;
    v = (v << 5) + d;
  }
  *out = v;
  return true;
}

uint64_t GuidToMid(string_view guid) {
  if (guid.size() != 32) return -1;
  uint64_t hi = HexToU64(guid.substr(0, 16)), lo = HexToU64(guid.substr(16, 16));
  uint64_t graph = hi - 0x9202a8c04000641f;                    // comparaison non signée
  if (lo < 0x8000000000000000 || lo > 0x80000003ffffffff || graph >= 8) return -1;
  return MakeMid(graph, lo & 0x3ffffffff);                     // 34 bits de valeur
}

uint64_t ParseMid(string_view s) {
  if (s.size() >= 4 && s[0] == '/' && s[2] == '/') {
    int graph;
    switch (s[1]) {
      case 'm': graph = 0; break;   case 'g': graph = 1; break;
      case 't': graph = 2; break;   case 'x': graph = 3; break;
      case 'n': graph = 4; break;   case 'p': graph = 5; break;
      case 'r': graph = 6; break;                              // réservé, jamais observé
      default: return -1;                                      // 's' compris, sans message
    }
    char c0 = s[3];
    if ((c0 & 0x78) != 0x30) return -1;                        // '0' à '7' : version 0
    uint64_t value;
    if (c0 == '7' || !ParseMunch(s.substr(4), &value)) {
      VLOG(1) << "Invalid mid characters: " << s;              // ligne 256 du fichier source
      return -1;
    }
    uint64_t mid = MakeMid(kMunchValue[c0], value);
    if (mid == -1) return -1;
    return ((mid >> 59) & 7) == graph ? mid : -1;              // la lettre et le chiffre doivent concorder
  }
  if (StartsWith(s, "/guid/")) return GuidToMid(s.substr(6));
  if (StartsWith(s, "#"))      return GuidToMid(s.substr(1));
  return -1;
}

string MidToString(uint64_t mid) {
  if (mid == 0) return "/m/0";
  uint64_t top = mid >> 59;                                    // version + graphe
  if (top >= 7) return "";                                     // /s/ ou version non nulle
  char buf[13];
  return StrCat(kPrefix[top], kMunch[top], MunchDigits(mid & kMaxValue, buf)); // base 32 sans zéro de tête
}
VLOG(1) est une lecture du binaire : avant d'écrire, le code teste un niveau de journal, mais la macro exacte n'est pas connue. kMunchValue est la table inverse de l'alphabet, MunchDigits écrit les chiffres de droite à gauche dans un tampon de 13 caractères.
Deux messages, et beaucoup de silences
Le fichier ne contient que deux messages d'erreur : « Mid exceeds max size 0x… for namespace … » à la ligne 226, quand une valeur dépasse 59 bits, et « Invalid mid characters: » à la ligne 256, quand un caractère sort de l'alphabet. Un préfixe inconnu, un /s/ ou une lettre qui ne concorde pas avec le premier chiffre renvoient −1 sans rien écrire au journal.
Tout le reste est de la donnée : l'alphabet, la table des huit préfixes, la table inverse, et les deux écritures d'un GUID Freebase, /guid/ et #.
Valentin Pletzer
Ce qui était connu, ce qui est neuf
Valentin Pletzer avait compris depuis longtemps comment un MID devient un entier. En mai 2019, il y a sept ans, c'est lui qui posait la question sur Stack Overflow, avec la paire /g/11b6377dzp et 576462201963131861 relevée dans une URL Google. La règle, 259 pour l'espace /g/ plus le reste lu en base 32, figure dans son gist, qui convertit un MID en nombre, et inversement.
L'alphabet et la conversion des /m/ depuis les GUID Freebase sont documentés depuis 2010, et Google a publié en 2020 un code Python de l'époque Freebase (pymql). Son fichier mql/mid.py garde en exemple quatre GUID Freebase, dont un recopié deux fois. Décodés, ils donnent trois entités distinctes, que Google affiche toujours : /m/0r5_5s, /m/0q8g1g (« American Dream (Afterlife mix) ») et /m/0mx1ng (« Young and Fine », une chanson de Weather Report).
Ce que nous ajoutons : le codec complet avec ses contrôles, reconstruit à partir du binaire original. Les 3,4 millions de MID de notre corpus passent tous le codec, aller-retour compris, contre 2,7 % pour des chaînes tirées au hasard. 27 des 30 entiers relevés dans des URL Google désignent l'entité cherchée.
Ce qu'un MID ne contient pas. Aucune clé de contrôle : 37 258 groupes de /g/11 ne diffèrent que par leur dernier caractère, et une faute de frappe passe donc les contrôles du codec. Aucun lien calculable entre le /m/ et le /g/ d'une même entité (13 492 paires testées), ni avec le numéro Wikidata, le CID Google Maps ou le code EAN. Les identifiants c-… du Knowledge Graph d'entreprise de Google Cloud contiennent des voyelles : ils suivent un autre alphabet et ne se convertissent pas.
Rien dans le format ne dit non plus si l'entité est un produit, un lieu ou autre chose : tous sont des /g/ écrits de la même façon. Seule la position de la valeur le trahit. Google crée les produits Shopping par lots, dans des plages réservées des tranches /g/11k à /g/11z : 94 % des produits ont pour plus proche voisin un autre produit, contre 75 % si l'on mélange les étiquettes à époque égale. L'outil le signale quand un MID tombe dans une telle plage. Les anciens lieux ont leurs propres blocs ; les lieux récents, eux, se mêlent aux autres entités et se repèrent mal. Pour une fiche Google Maps, le MID ne se calcule ni depuis le CID ni depuis le Place ID : il faut le demander à Maps, qui le renvoie avec la fiche quand on l'interroge par son CID.
Côté Wikidata, l'expression régulière de la propriété P2671 (identifiant Google Knowledge Graph) liste les blocs connus au moment où elle a été écrite, pas la règle de Google : elle refuse 59 /g/ valides sur 2,4 millions. La règle exacte tient en une ligne : /g/1 suivi de 1 à 12 caractères de l'alphabet, sans zéro en tête, pour une valeur inférieure à 259.
Et les Place ID de Google Maps ? La page « Place IDs » de la documentation Google donne cinq exemples sans dire ce qu'ils désignent. Décodés, ils pointent tous vers le même endroit, 13 Market St à Wilmington (Caroline du Nord), écrit de cinq façons : une fiche, un point GPS, l'adresse en clair (deux variantes) et une rue suivie d'un numéro. Seul le Place ID qui commence par ChIJ est une vraie fiche, avec son propre MID, /g/11fj9d5c11, que l'outil date de janvier 2019. Les quatre autres n'ont ni fiche, ni avis, ni entité : une adresse saisie qui ne correspond à aucun lieu connu reçoit un Place ID de ce genre.
Le CID, le numéro d'une fiche Maps (celui des liens maps.google.com/?cid=), est en général un nombre de 64 bits tiré au hasard : il ne dit rien de l'âge ni de l'emplacement du lieu. Exception : des communes importées en lot à partir des listes officielles, sans doute vers 2005-2009. En France, leurs CID se suivent de 16 en 16, dans l'ordre décroissant des codes INSEE. De Bois-le-Roi (77037) à Paris (75056), l'écart vaut exactement 781 crans : les 35 dernières communes de Seine-et-Marne, les 745 de Seine-Maritime, puis Paris, selon la liste en vigueur de 2005 à 2012. En Italie, le même mécanisme suit les codes ISTAT, avec les provinces d'avant 2009. Les MID Freebase de ces communes gardent parfois une trace du même genre : en Seine-et-Marne, ils croissent avec le code INSEE presque sans exception, en Seine-Maritime non. Sur 92 départements, cet ordre est net dans 9.
Comment Google consolide, classe et affiche les lieux dans Geostore : Google Map disséqué.