Tests · Octobre 2026

Chrome prépare une API qui transforme ce que tapent vos visiteurs en filtres : de 38 % à 85 % de bonnes réponses selon le moteur

Un internaute tape « citadine électrique pas chère » dans la recherche d’un site automobile. Avec l’API de décision, que Google prépare pour Chrome, le site pourra demander au navigateur de cocher les bons filtres, sans passer par un serveur. Nous l’avons testée avec les trois modèles d’IA qui peuvent la faire tourner, puis comparé le modèle actuel de Chrome à sa version 2, sortie le 6 octobre.

37,9 %de bonnes réponses avec EmbeddingGemma
63,8 %de bonnes réponses avec Laya
85,2 %de bonnes réponses avec Gemma 4
Powered by RESONEO

Google prépare dans Chrome deux outils d’IA que les sites pourront appeler. L’API d’embedding résume le sens d’un texte en une « signature de sens », une liste de nombres qui sert par exemple à ranger des pages par thème. L’API de décision répond à des questions fermées (oui ou non, un choix dans une liste, une note) sur ce que l’internaute tape sur le site. Les deux calculent sur l’ordinateur de l’internaute, et aucune n’est encore active. Le 6 octobre, Google a publié EmbeddingGemma 2, la nouvelle version du modèle de Chrome, et ajouté l’API de décision au code de Chrome. Nous avons testé l’API de décision sur 414 requêtes et comparé les deux versions du modèle sur 151 pages.

Sommaire

1

Google veut que Chrome comprenne les textes sans passer par ses serveurs, mais rien n’est encore actif

Les trois raisons que donne Google (proposition de l’API de décision, fiche Chrome de l’API d’embedding, annonce d’EmbeddingGemma 2), notre lecture, puis l’état réel de Chrome au 7 octobre 2026.

1

Moins cher et plus privé qu’une IA en ligne

Le calcul se fait sur l’ordinateur de l’internaute : pas de serveur à payer, aucune donnée personnelle envoyée. Quand un visiteur tape « veste imperméable femme pas chère » dans la recherche d’un site de mode, le site peut ranger sa demande dans les bons rayons sans payer une IA en ligne. Et tous les sites partagent le même modèle.

2

Transformer une phrase en filtres ou en actions

Google vise les sites qui doivent décider vite à partir d’une phrase. Sur un site d’hôtels, quels filtres cocher pour « acceptant les chiens, pas trop cher » ? Dans un service de stockage en ligne, quel bouton actionner quand on tape « partager ce fichier avec mes collègues » ?

3

Des modèles qui choisissent au lieu de rédiger, dans la lignée de Jev

Selon Google, faire rédiger une réponse par un grand modèle pour choisir entre trois options est « 10 à 50 fois » plus lourd. Google reprend l’idée de Jev, lancé le 15 septembre par la start-up TypeSafe AI : un modèle qui ne rédige pas, mais choisit entre des réponses fixées d’avance. Il le cite dans sa fiche Chrome et a publié sa proposition quinze jours plus tard. Chrome ne fait pas tourner Jev pour autant : ses moteurs sont EmbeddingGemma, Laya (un équivalent open source de Jev) et Gemma 4, un grand modèle plus juste mais plus lent.

4

Notre lecture : après Topics, Google laisse les sites créer leurs catégories

Google a d’abord voulu classer les internautes pour la publicité (Topics), puis les pages selon la taxonomie publicitaire IAB (Classifier API), et a abandonné les deux. Il donne désormais aux éditeurs l’outil pour créer leurs propres rubriques, comme « trail en montagne » ou « premier marathon », et y ranger leurs pages. Ni la proposition de l’API de décision ni la fiche Chrome de l’API d’embedding ne parlent de publicité.

De Topics à l’API de décision : le calendrier depuis octobre 2025

Oct. 2025
Arrêt de la Privacy Sandbox (Topics et le reste)
Les cookies tiers restent ; le plan « sans cookies » s’arrête
18 mai 2026
Abandon de la Classifier API, « faute de signaux d’intérêt »
La taxonomie publicitaire imposée n’a pas pris
26 mai 2026
Annonce du prototype de l’API d’embedding
Le remplaçant de la Classifier API
Août 2026
L’API d’embedding apparaît dans Chrome Canary, la version de test de Chrome
Les sites peuvent obtenir la signature de sens d’un texte
15 sept. 2026
La start-up TypeSafe AI lance Jev, un modèle qui choisit au lieu de rédiger
Des équivalents open source, dont Laya, suivent dans la semaine
1er oct. 2026
Google publie la proposition de l’API de décision
Elle cite Jev comme exemple
5 oct. 2026
Chrome déclare trois modèles Laya
Un moteur de décision dédié se prépare
6 oct. 2026
Sortie d’EmbeddingGemma 2 ; l’API de décision arrive dans le code de Chrome, sans moteur
Modèle et usage arrivent ensemble

Où en est vraiment Chrome au 7 octobre 2026 : rien n’est actif chez les internautes

Tout se prépare dans les versions de test de Chrome. Rappel : une « signature de sens » est une liste de 768 nombres qui résume un texte ; « veste imperméable femme » et « manteau de pluie pour femme » obtiennent des signatures proches sans avoir un mot en commun.

ÉlémentCe que c’estDans Chrome au 7 octobre
EmbeddingGemma 2Modèle ouvert qui transforme texte, image, son ou vidéo en signature de sens ; 100 languesAbsent : Chrome livre toujours EmbeddingGemma 1 (mai 2026)
API d’embeddingCalcule la signature de sens d’un texte pour le sitePrésente mais désactivée, même dans Chrome grand public
API de décisionRépond aux questions fermées d’un site sur ce que tape l’internauteArrivée dans Chrome Canary le 7 octobre, derrière un réglage avancé. Sans moteur, elle répond « indisponible »
LayaÉquivalent open source de Jev, créé hors de GoogleDéclaré depuis le 5 octobre, mais Chrome ne sait pas encore l’exécuter
Gemma 4Grand modèle qui rédige, déjà utilisé par d’autres outils IA de ChromeSon branchement à l’API de décision est en relecture chez Google
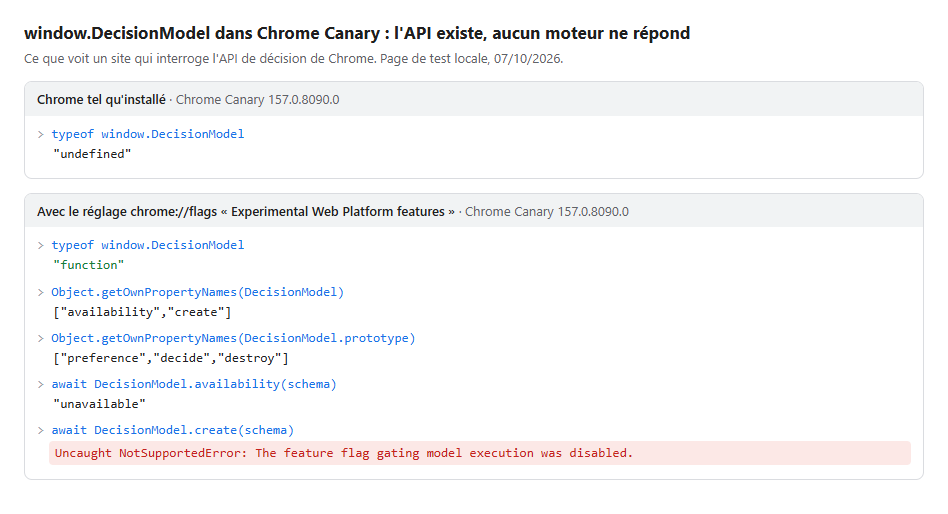
Console de Chrome Canary : l’API de décision (DecisionModel) existe avec le réglage expérimental, mais répond « unavailable » et refuse de démarrer
Ce que voit un site qui appelle l’API de décision dans Chrome Canary 157 : avec le réglage « Experimental Web Platform features », elle existe mais refuse de démarrer.
2

Comment s’y préparer ?

Rien n’est encore actif, mais nos tests disent déjà quoi faire, métier par métier.

MétierCe qui arriveCe que vous pouvez faire, et où
E‑commerceChrome pourra transformer une recherche tapée sur le site en filtresDans le code de la page : écrire le schéma, avec une phrase par filtre et par valeur (exemple ci-dessous). Dans l’historique de votre moteur de recherche interne : réunir de vraies requêtes pour le tester dès l’ouverture de l’API
SEO et contenuDes sites et des tags pourront classer les pages par thème dans Chrome, qui n’en lit que les 1 500 premiers mots environDans le contenu de la page : dire de quoi elle parle dès le titre, le chapô et les deux premiers paragraphes
Brand safety et ciblage contextuelUn tag tiers autorisé par l’éditeur pourra classer la page au moment de l’affichageDans les réglages de votre outil de brand safety : définir chaque thème interdit en une phrase, et prévoir de revoir les seuils à chaque changement de modèle
Data et produitDes signatures de sens calculées gratuitement sur l’ordinateur du visiteurDans votre base de données : stocker avec chaque signature le texte source et le nom du modèle, pour tout recalculer. Ne jamais comparer les signatures de deux modèles

Préparez-vous en rédigeant dès maintenant vos questions et leurs réponses

En pratique, le développeur du site ajoute à la page un petit script. Ce script décrit les questions dans un « schéma », un objet proche du JSON : pour chaque question, son intitulé et ses réponses possibles. Quand le visiteur lance sa recherche, le script transmet le texte tapé à Chrome, qui renvoie pour chaque question la réponse choisie et un score de confiance ; le script coche alors les filtres. Exemple pour un site automobile :

// Le schéma : les questions que Chrome devra trancher
const schema = {
  context: "",  // laissé vide
  questions: [{
    id: "carrosserie",
    type: "choice",
    prompt: "Quelle carrosserie le visiteur cherche-t-il ?",
    options: [
      { label: "citadine", description: "petite voiture urbaine, facile à garer" },
      { label: "berline",  description: "voiture familiale avec un grand coffre" },
      { label: "suv",      description: "véhicule haut et spacieux, type 4x4" }
    ]
  }]
};

// Le texte tapé par le visiteur part vers Chrome, qui choisit une réponse
const modele = await DecisionModel.create(schema);
const reponse = await modele.decide(texteTape);
// reponse.carrosserie : réponse choisie + score de confiance de 0 à 1

Dans nos tests, quatre réglages de ce schéma font passer le modèle actuel de Chrome de 38 % à 58 % de bonnes réponses :

  • Remplir le champ « description » de chaque réponse possible (+13 points).
  • Laisser vide le champ « context », où le site peut se présenter (+10 points sur les listes de choix).
  • Préférer les listes de choix décrits aux questions oui/non, et éviter les réponses fourre-tout comme « autre ».
  • Dans le script, ne rien cocher automatiquement : avec le modèle actuel, le score de confiance n’est pas fiable. Proposer plutôt les filtres au visiteur.

Ces réglages sont à refaire à chaque modèle : le même schéma tombe à 45 % avec EmbeddingGemma 2.

Trois signaux à surveiller dans Chrome

  • Le jour où Chrome remplace EmbeddingGemma 1, tous les seuils et toutes les signatures stockées sont à refaire.
  • La mise en service de Laya rendrait l’API de décision plus juste qu’avec EmbeddingGemma, et plus rapide qu’avec Gemma 4.
  • Les deux API demandent aujourd’hui un réglage avancé. L’étape suivante est un essai ouvert aux sites inscrits (Origin Trial).
3

L’API de décision à l’essai : 38 %, 64 % ou 85 % de bonnes réponses selon le moteur

L’API ne fonctionne pas encore dans Chrome : nous l’avons reconstruite d’après son code. Nous avons ensuite écrit les questions de 11 sites fictifs (automobile, hôtels, électroménager…), puis tapé 414 recherches et messages, en français et en anglais, pour vérifier si l’API choisit les bonnes réponses.

L’API confie chaque question à un modèle d’IA, son « moteur ». Google en prévoit trois : EmbeddingGemma, déjà dans Chrome et rapide (0,2 seconde par décision) ; Laya, un équivalent open source de Jev créé hors de Google (1,5 seconde) ; Gemma 4, un grand modèle déjà utilisé par d’autres outils de Chrome (2,4 secondes).

Part de bonnes réponses, par moteur et par type de question
1 365 décisions sur 414 requêtes en français et en anglais. Survolez une barre pour le détail.
EmbeddingGemma (modèle actuel de Chrome)LayaGemma 4
Toutes les décisions
EmbeddingGemma
37,9 %
Laya
63,8 %
Gemma 4
85,2 %
Questions oui/non
EmbeddingGemma
28 %
Laya
72 %
Gemma 4
93 %
Questions à choix
EmbeddingGemma
47 %
Laya
63 %
Gemma 4
82 %
Notes de 1 à 5
EmbeddingGemma
50 %
Laya
26 %
Gemma 4
59 %
Questions rédigées en français
EmbeddingGemma
34,8 %
Laya
61,6 %
Gemma 4
83,3 %

Questions oui/non : la bonne réponse est « non » dans 80,5 % des cas, car la plupart des requêtes ne parlent pas du critère demandé.

Une recherche tapée sur un site automobile, trois moteurs : « citadine électrique pas chère »

Filtre du site automobile Bonne réponse EmbeddingGemma Laya Gemma 4
Carrosseriecitadinepeu importeberlinecitadine
Motorisationélectriquepeu importeélectriqueélectrique
Boîte automatique exigéenonouinonnon
Faible kilométrage exigénonouinonnon
Budget, de 1 à 41421
Filtres justes50 sur 53 sur 55 sur 5

Fond vert : réponse juste. Fond rose : réponse fausse.

Pourquoi EmbeddingGemma se trompe

14 sur 18

Les questions oui/non ignorent la recherche

Pour « chalet à la montagne pour 8 personnes », tapé sur un site de location, il coche « animaux acceptés », « piscine » et « parking ». 14 questions oui/non sur 18 reçoivent la même réponse, quoi que l’on tape.

70 %

Les options « autre » aspirent les réponses

EmbeddingGemma choisit « autre » ou « peu importe » 70 % du temps, alors que c’est la bonne réponse dans 26 % des cas. « Lave-linge silencieux 9 kg » finit dans « autre appareil ».

1 sur 1 365

Le score de confiance ne sert à rien

Chaque réponse arrive avec un score de confiance, de 0 à 1. Dans ses exemples, Google n’applique la réponse qu’au-dessus de 0,85. Une seule décision sur 1 365 dépasse ce seuil.

La cause : la phrase que Chrome construit autour de la recherche

Chrome ne compare pas la recherche seule aux réponses possibles : il l’insère dans une phrase avec la question et la présentation du site, où elle ne pèse plus qu’un cinquième. Toutes les recherches finissent par se ressembler. Avec le même modèle, comparer la recherche seule à chaque réponse donne 63 % de bonnes réponses, 25 points de plus.

Laya et Gemma 4 font mieux, mais ne sont pas prêts

Gemma 4 : juste et fiable, mais lourd

C’est le seul moteur dont le score de confiance est utile : 80 % des réponses dépassent 0,85, et 91 % de celles-ci sont justes. Mais il lui faut 2,4 secondes par décision et plus de 4 Go sur l’ordinateur. Son branchement est en relecture chez Google.

Laya : déclaré dans Chrome, mais débranché

Laya fait 64 % et tombe bien moins dans les options « peu importe » (21 % au lieu de 70 %). Chrome déclare trois modèles Laya depuis le 5 octobre, mais Google a retiré le code qui les branchait : Chrome ne sait pas encore les faire tourner. Nous l’avons testé avec les fichiers publics du même nom.

Et avec EmbeddingGemma 2 comme moteur ?

51,5 % de bonnes réponses, mais seulement parce qu’il répond plus souvent « non », ce qui tombe juste quand la recherche ne parle pas du critère. Sur les listes de choix, aucun progrès.

Les moteurs reproduisent du code que Google peut encore modifier avant toute sortie.

4

EmbeddingGemma 2 classe les pages aussi bien que le modèle actuel, mais tous les seuils sont à refaire

L’autre usage du modèle de Chrome : ranger des pages par thème avec l’API d’embedding, pour un site ou un tag publicitaire qui veut savoir de quoi parle une page. Nous avons comparé les deux versions sur 151 pages réelles de 45 sites, en français et en anglais, réparties en 12 thèmes.

Même précision
95,4 %
de pages bien classées avec les deux modèles
Des scores tassés
÷ 2
l’écart entre le thème retenu et le suivant
Deux modèles incompatibles
13 %
de pages bien classées si l’on mélange les deux modèles
Lire toute la page n’aide pas
91,4 %
des pages longues bien classées en entier, contre 96,6 % sur les 1 500 premiers mots
Pour EmbeddingGemma 2, deux textes sans rapport se ressemblent déjà à 0,70
La similarité va de 0 (rien à voir) à 1 (identiques). Un seuil de 0,62, qui isolait les pages « à éviter » avec le modèle actuel, est dépassé par n’importe quel texte avec EmbeddingGemma 2.
seuil « à éviter » : 0,62
Modèle actuel de ChromeEmbeddingGemma 1
0,25
0,81
EmbeddingGemma 2sorti le 6 octobre
0,70
0,94
00,250,500,751
Cercle vide : deux textes sans aucun rapport Cercle plein : « le chat est assis » et « le chien est assis »

Un seuil réglé aujourd’hui sera faux demain

Avec le modèle actuel, ce seuil de 0,62 ne signalait aucune page normale ; avec EmbeddingGemma 2, il les signale toutes. Et les signatures des deux modèles n’ont presque rien en commun : toute base calculée avec l’ancien est à refaire.

Le sujet et l’intention restent confondus

Une pub de paris sportifs et un avant-match de football obtiennent presque le même score face à un profil « contenus à éviter » (0,871 et 0,845). Ce qui marche, avec les deux modèles : décrire chaque thème interdit en une phrase, comme « contenu qui incite à parier : offres de paris, cotes boostées, bonus de casino ».

Plus lent, et les exemples le desservent

EmbeddingGemma 2 est 2 à 5 fois plus lent que le modèle actuel. Ajouter trois exemples par thème lui fait perdre 11 points : une seule phrase de définition fonctionne mieux.

Ses vrais progrès : le code, l’image, le son et la vidéo

Sur le texte, EmbeddingGemma 2 ne progresse presque pas (61,36 contre 61,15 sur MTEB, le banc de test de référence). Il gagne 9,9 points sur le code informatique et lit désormais images, son et vidéo. Rien de cela n’arrive dans Chrome, dont l’API ne traite que du texte.

Sources et méthode

  • API de décision : trois moteurs reproduits d’après le code de Chrome, le moteur EmbeddingGemma vérifié dans Chrome Canary 157 (aucun écart sur 1 506 décisions). 414 requêtes en français et en anglais, 11 schémas, 1 365 décisions.
  • Classement de pages : 151 pages publiques de 45 sites, 12 thèmes définis chacun par une phrase en anglais. Modèle actuel mesuré dans Chrome Canary, EmbeddingGemma 2 avec les poids publiés par Google.
  • Limites : requêtes écrites et étiquetées par une seule personne ; le code de Chrome peut encore changer.

Sources consultées

Autres sources et études

Oct 2026 Search & fan-out capture V6 : notre extension Chrome capture aussi Gemini (fan-out, passages cités, classifieur de prompts) et les pubs ChatGPT Oct 2026 API de décision de Chrome testée : transformer ce que tapent les visiteurs en filtres, de 38 % à 85 % de bonnes réponses selon le moteur, et EmbeddingGemma 2 comparé Oct 2026 Google Lens Shopping : le classement des 752 catégories d'objets (ALLOWLIST, NEUTRAL, DENYLIST) et la liste appliquée en 2026 Sept 2026 Google Ads deep dive : comment Google Ads lit le site, relie les pages aux requêtes, génère les créations et prépare l'enchère Sept 2026 RESONEO Shop, une démo WebMCP : 135 outils exposés à un agent IA, 33 scénarios guidés, données en direct et simulées Août 2026 Ce que ChatGPT récupère, ce qu'il montre, ce qu'il cite (mis à jour : il cherche beaucoup moins large, et cite autant) Août 2026 Google Map disséqué : 72 signaux de ranking et l'architecture qui relie le Web, les lieux et l'IA Juil 2026 ChatGPT experiments tracker : ce qu'OpenAI teste avant de le déployer Juil 2026 Comment votre téléphone Google vous tracke pour « mieux vous servir » Juin 2026 3 729 456 URLs internes de Google, sans en ouvrir aucune More stuffs...
RESONEO